تفاوت GPT، Claude، Gemini و DeepSeek؛ کدام مدل برای چه کاری؟
مقایسه چهار خانواده اصلی مدلهای هوش مصنوعی بر اساس مستندات رسمی سازندگان و یک آزمایش واقعی با یک مسئله یکسان: سرعت، حجم پاسخ، هزینه و سبک هرکدام.
وقتی چند مدل هوش مصنوعی جلوی شماست، سؤال طبیعی این است: کدام بهتر است؟ پاسخ کوتاه این است که «بهتر» به کاری که میخواهید انجام دهید بستگی دارد. تفاوت GPT، Claude، Gemini و DeepSeek بیشتر در سرعت، هزینه، سبک نوشتن و رفتارشان در کارهای طولانی است تا در اینکه یکی همیشه درست بگوید و دیگری غلط.
در این مقاله اول میبینیم سازنده هر خانواده چه میگوید، بعد یک مسئله واقعی را به چهار مدل میدهیم و نتیجه را کنار هم میگذاریم، و در پایان یک راه ساده برای انتخاب پیشنهاد میکنیم.
چرا مدلها به یک سؤال پاسخهای متفاوت میدهند؟
هر مدل روی دادههای متفاوتی آموزش دیده، با روشهای متفاوتی تنظیم شده و سازندهاش سلیقه متفاوتی در طول پاسخ، لحن و میزان احتیاط داشته است. حتی یک مدل هم اگر دو بار همان سؤال را بگیرد، ممکن است دو جواب کمی متفاوت بدهد.
به همین دلیل، مقایسه درست یعنی یک درخواست یکسان، در شرایط یکسان، و بررسی نتیجه با معیاری که بتوان اندازه گرفت؛ نه اینکه از هر مدل یک سؤال جدا بپرسیم و حس کنیم کدام «باهوشتر» بود.
هر سازنده درباره مدلهای خودش چه میگوید؟
این بخش خلاصهای از مستندات رسمی است، نه نظر ما. تاریخ بررسی مستندات: 1405/06/29.
GPT از OpenAI
در مستندات مدلهای OpenAI، نسل GPT-5.6 سه نسخه اصلی دارد: gpt-5.6-sol بهعنوان مدل پرچمدار برای «کارهای حرفهای پیچیده»، gpt-5.6-terra با تعادل میان هوشمندی و هزینه، و gpt-5.6-luna که برای کارهای حساس به هزینه بهینه شده است. پنجره متن این سه مدل 1.05 میلیون توکن و حداکثر خروجیشان 128 هزار توکن اعلام شده است.
Claude از Anthropic
مستندات Anthropic چهار مدل فعلی را اینطور توصیف میکند: Claude Opus 5 برای «کدنویسی پیچیده و کارهای سازمانی»، Claude Sonnet 5 بهعنوان «بهترین ترکیب سرعت و هوشمندی»، Claude Haiku 4.5 بهعنوان سریعترین مدل، و Claude Fable 5.1 برای استدلال سنگین و کارهای طولانی. پنجره متن سه مدل اول 1 میلیون توکن و Haiku 4.5 حدود 200 هزار توکن است.
Gemini از Google
در فهرست مدلهای Gemini، هر نسخه یک کاربرد اعلامشده دارد؛ برای نمونه gemini-3.7-flash برای «کدنویسی پیچیده، جریانهای کاری عاملی و اجرای چندمرحلهای قابل اتکا» معرفی شده و gemini-3.5-flash-lite بهعنوان سریعترین و کمهزینهترین گزینه آن نسل. مدلهای تصویری این خانواده با نام Nano Banana شناخته میشوند.
DeepSeek
مستندات DeepSeek برای deepseek-flash (نسخه DeepSeek-V4.1-Flash) پنجره متن 1 میلیون توکن و پشتیبانی از خروجی JSON، فراخوانی ابزار و ورودی تصویری را اعلام کرده است. برای deepseek-v4-pro هم پنجره متن 1 میلیون توکن و حداکثر خروجی 384 هزار توکن ذکر شده، اما پشتیبانی از تصویر ندارد.
این عددها مشخصات اعلامشده سازندهاند و بهمرور تغییر میکنند. اگر تصمیم مهمی میگیرید، همان روز مستندات رسمی را ببینید.
یک آزمایش واقعی: یک مسئله، چهار مدل
برای اینکه مقایسه فقط نقلقول از مستندات نباشد، یک مسئله کوچک ولی قابلسنجش را به چهار مدل دادیم. مسئله سه شرط سخت داشت و یک محدودیت طول:
یک تیم پشتیبانی چهارنفره داریم که باید ساعت 8 صبح تا 8 شب را پوشش دهد. هر نفر حداکثر 8 ساعت در روز کار میکند و در هر لحظه باید دستکم دو نفر همزمان حاضر باشند. یک برنامه شیفت بنویس و در یک جمله توضیح بده چرا هر سه شرط برقرار است. حداکثر 150 کلمه بنویس.
این مسئله عمداً طوری انتخاب شد که بتوان جواب را با حساب ساده بررسی کرد: پوشش کامل بازه، سقف 8 ساعت برای هر نفر، و حضور همزمان دستکم دو نفر.
نتیجه
هر چهار مدل به یک برنامه معتبر رسیدند: دو نفر از 8 تا 16 و دو نفر از 12 تا 20. با این چیدمان، از 8 تا 12 دو نفر، از 12 تا 16 چهار نفر و از 16 تا 20 دو نفر حاضرند؛ هر نفر هم دقیقاً 8 ساعت کار میکند. محدودیت 150 کلمه را هم هر چهار مدل رعایت کردند.
تفاوتها جای دیگری بود:
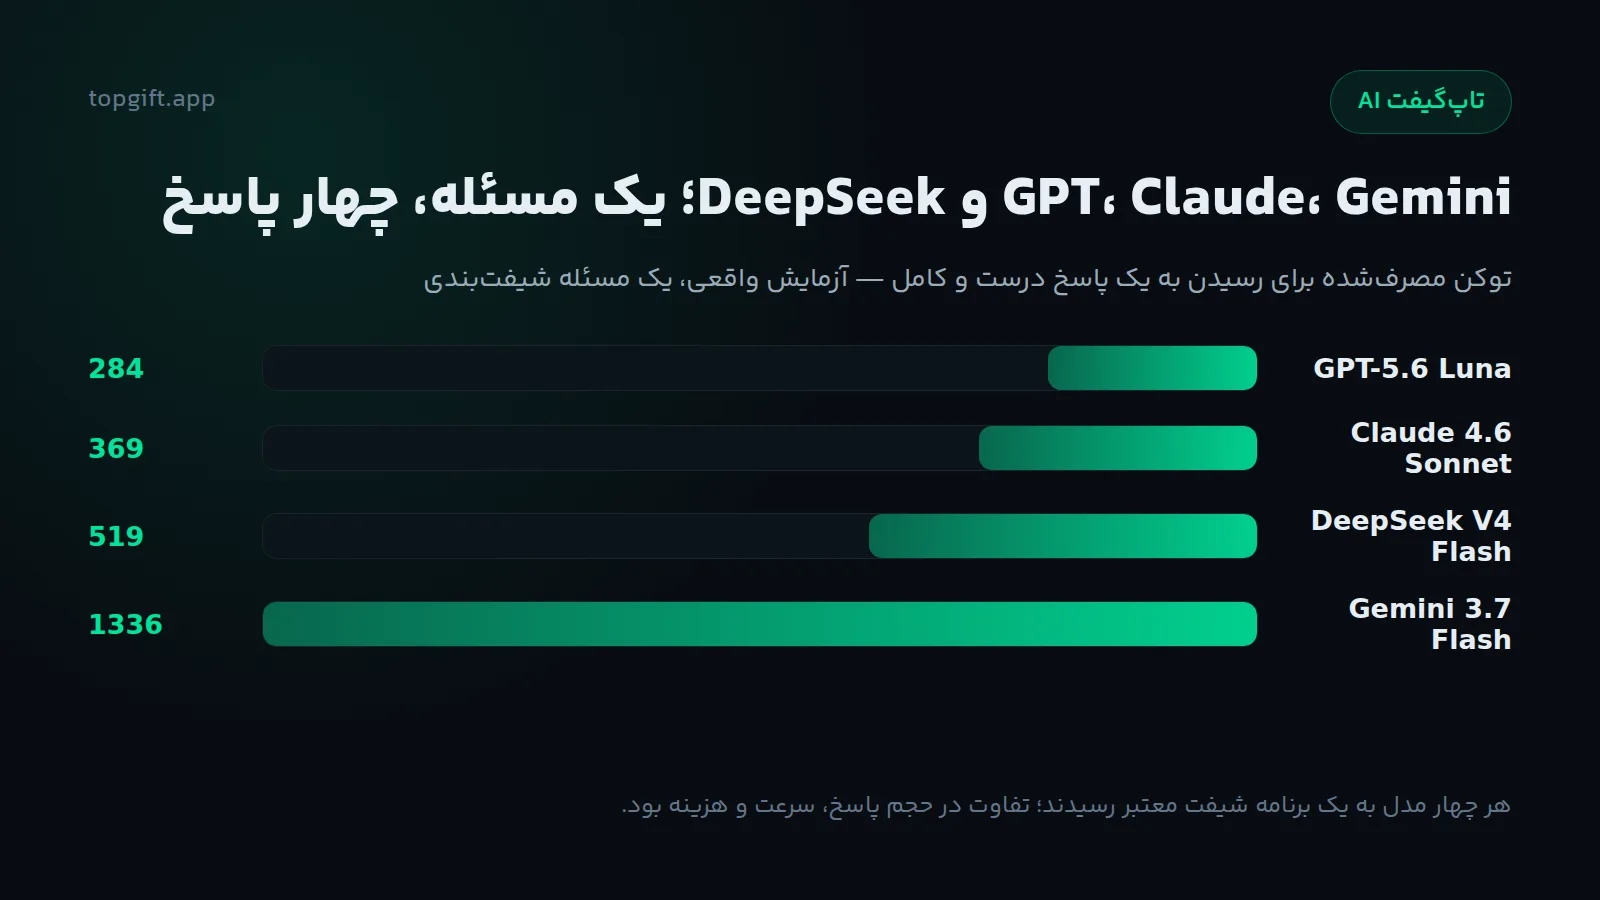
GPT-5.6 Luna: کوتاهترین و سریعترین پاسخ — 284 توکن خروجی در حدود 4 ثانیه. جواب را در قالب جدول داد.
Claude 4.6 Sonnet: 369 توکن در حدود 7 ثانیه. تنها مدلی بود که برای اعضای تیم اسم فرضی گذاشت و جدولش ستون «ساعات کاری» هم داشت.
DeepSeek V4 Flash: 519 توکن در حدود 7 ثانیه، با فهرست ساده و بدون جدول. ارزانترین پاسخ این آزمایش بود.
Gemini 3.7 Flash: برای رسیدن به پاسخ کامل به 1336 توکن و حدود 10 ثانیه نیاز داشت؛ یعنی حدود پنج برابر مدل اول در همان مسئله.
یک نکته مهم درباره همین آزمایش: در اجرای اول ما سقف خروجی را روی 450 توکن گذاشته بودیم و پاسخ دو مدل وسط کار قطع شد. این محدودیت را ما گذاشته بودیم، نه مدلها؛ با فضای بیشتر، هر چهار مدل پاسخ کامل دادند. اگر جایی دیدید یک مدل «ناقص جواب میدهد»، اول ببینید سقف خروجی چقدر بوده است.
این آزمایش چه چیزی را نشان نمیدهد
یک مسئله، یک بار اجرا، در یک زبان. این نتیجه یعنی «در این مسئله مشخص، این رفتار را دیدیم»، نه اینکه یک مدل بهطور کلی بهتر از دیگری است. برای تصمیم جدی، همان کار واقعی خودتان را روی دو یا سه مدل امتحان کنید.
اعداد بالا در تاریخ 1405/06/29 و از طریق همان مسیری گرفته شدهاند که هوش مصنوعی تاپگیفت برای پاسخدادن استفاده میکند. زمان پاسخ به شرایط شبکه و بار سرویس بستگی دارد و هر بار یکسان نیست.
پس کدام مدل را انتخاب کنم؟
بهجای دنبالکردن «بهترین مدل»، از نوع کارتان شروع کنید:
کار روزمره، خلاصهکردن، ایمیل و پرسشهای کوتاه: مدلهای سبک و سریع معمولاً کافیاند و اعتبار کمتری مصرف میکنند.
متن طولانی و کار تحریری: سبک نوشتن مدلها فرق دارد؛ همان متن را به دو مدل بدهید و آن را که به لحن شما نزدیکتر است نگه دارید.
کدنویسی: مدلهایی را انتخاب کنید که سازندهشان صریحاً برای کد معرفی کرده است. در این باره راهنمای هوش مصنوعی برای برنامهنویسی را ببینید.
سؤال درباره اطلاعات روز: مهمتر از انتخاب مدل، روشنبودن جستجوی وب است تا پاسخ به منابع امروز تکیه کند.
اگر مطمئن نیستید، لازم نیست خودتان انتخاب کنید: حالت انتخاب خودکار تاپگیفت AI بر اساس درخواست شما و در محدوده مدلهایی که پلنتان اجازه میدهد تصمیم میگیرد. حالت اقتصادی هم روی مصرف کمتر اعتبار تمرکز دارد.
در تاپگیفت به کدام مدلها دسترسی دارید؟
فهرست مدلها و اینکه هرکدام در کدام پلن فعال است، در جدول پلنها و مدلهای تاپگیفت AI آمده و بهمرور بهروز میشود. حسابهای بدون اشتراک به مجموعهای از مدلهای سبک هر چهار خانواده دسترسی دارند و با خرید اشتراک، مدلهای بیشتری در دسترس قرار میگیرد.
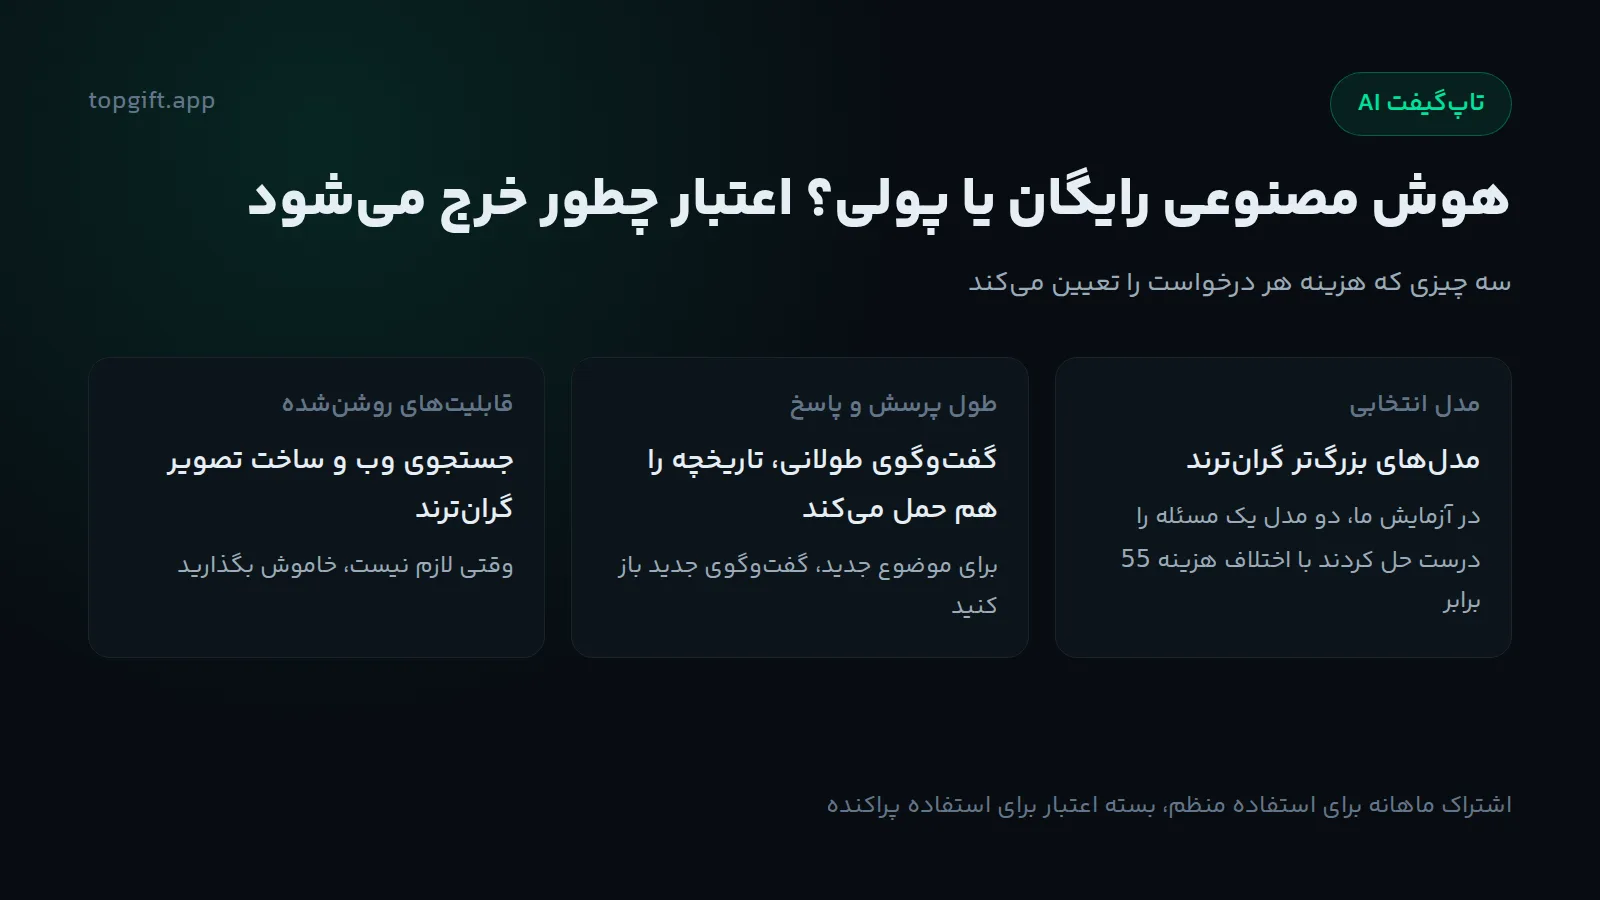
نکتهای که زیاد پرسیده میشود: دسترسی به یک مدل به معنی استفاده نامحدود نیست. هر درخواست بسته به مدل و قابلیتی که استفاده میکنید اعتبار مصرف میکند و مدلهای سنگینتر گرانترند. همین تفاوت هزینه در آزمایش بالا هم دیده شد: گرانترین پاسخ این آزمایش حدود 55 برابر ارزانترین پاسخ هزینه داشت، برای مسئلهای که هر دو درست حلش کردند. اگر میخواهید بدانید اعتبار دقیقاً چطور خرج میشود و بین بسته اعتبار و اشتراک کدام به کارتان میآید، راهنمای هوش مصنوعی رایگان یا پولی را ببینید.
درباره جدولهای مقایسهای که در اینترنت میبینید
بیشتر جدولهای «کدام مدل بهتر است» بر پایه بنچمارکها هستند. بنچمارکها مفیدند، اما دو محدودیت دارند: معمولاً انگلیسیاند و لزوماً کیفیت پاسخ فارسی را نشان نمیدهند، و کار روزمره شما هم بهندرت شبیه سؤالهای بنچمارک است. به همین دلیل، یک آزمایش کوچک با کار واقعی خودتان بیشتر از هر جدولی به تصمیمتان کمک میکند.
جمعبندی
تفاوت اصلی این چهار خانواده در «درست یا غلط» نیست؛ در سرعت، هزینه، سبک و رفتار در کارهای طولانی است. مستندات رسمی به شما میگوید هر مدل برای چه ساخته شده، و یک آزمایش کوچک با کار واقعی خودتان نشان میدهد کدامیک به نیاز شما نزدیکتر است. اگر هنوز با نوشتن درخواست راحت نیستید، از راهنمای سؤالپرسیدن از هوش مصنوعی شروع کنید؛ یک درخواست روشن، اختلاف مدلها را کمتر از آنچه فکر میکنید مهم میکند.
منابع این مقاله: فهرست مدلهای OpenAI، مرور مدلهای Claude، فهرست مدلهای Gemini و مستندات مدلهای DeepSeek.