هوش مصنوعی برای برنامهنویسی؛ از پرامپت تا کد تستشده
یک تمرین واقعی و کامل: تعریف مسئله، گرفتن کد از مدل، اجرای تستها، پیداکردن یک خطای واقعی و اصلاح آن — بههمراه الگوهای درخواست و نکات امنیتی.
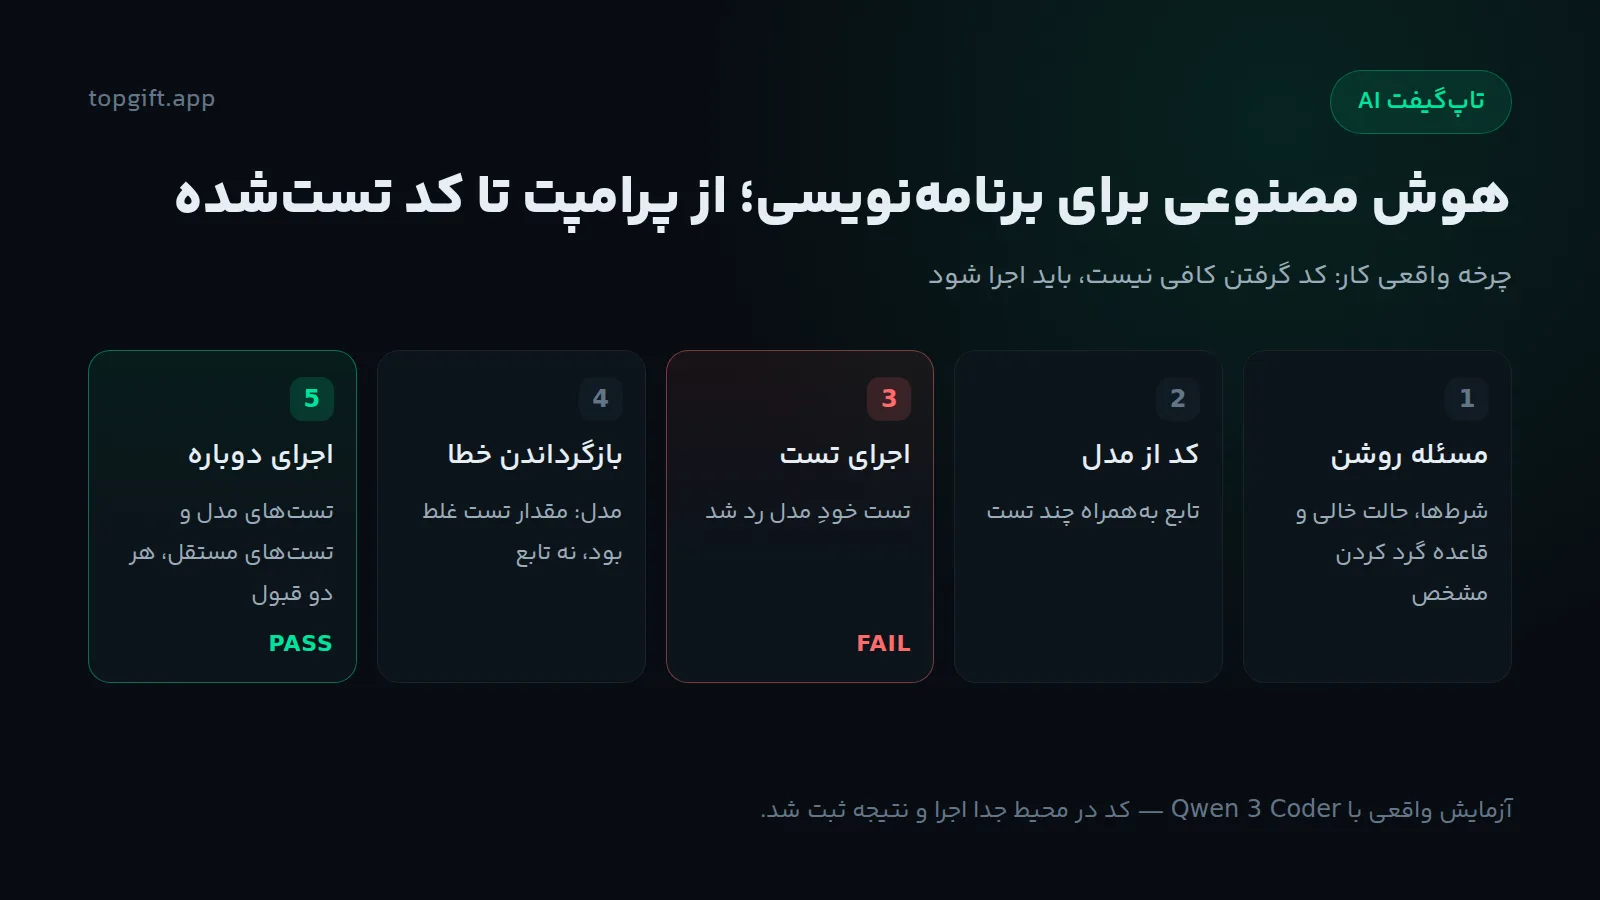
هوش مصنوعی در برنامهنویسی خیلی سریع کد مینویسد، ولی سرعت بدون بررسی بهدرد نمیخورد. در این راهنما یک تمرین کامل و واقعی را با هم جلو میبریم: مسئله را تعریف میکنیم، درخواست را مینویسیم، کد را از مدل میگیریم، اجرایش میکنیم و بر اساس نتیجه تست اصلاحش میکنیم.
نتیجه این تمرین یک درس غیرمنتظره داشت که در ادامه میبینید: کدی که مدل نوشت درست بود، اما تستی که خودش برای همان کد نوشت، غلط بود.
هوش مصنوعی در برنامهنویسی چه کاری میکند و چه کاری نمیکند
در عمل، این کارها را خوب انجام میدهد:
نوشتن توابع کوچک و مشخص از روی توضیح شما
توضیحدادن کدی که نوشتهاید یا به ارث بردهاید
پیشنهاد دلیل احتمالی یک خطا وقتی پیام خطا را میدهید
نوشتن تست، بازنویسی برای خوانایی، و تبدیل کد بین زبانها
و این کارها را نمیکند: نمیداند پروژه شما چه قراردادهایی دارد مگر اینکه بگویید، از اجرای کدش خبر ندارد مگر اینکه خودتان اجرا کنید، و مسئولیت درستی نتیجه با شماست. مدل متن تولید میکند؛ ضمانت نمیدهد.
تمرین واقعی: از صورتمسئله تا کد تستشده
گام 1: مسئله را دقیق تعریف کنید
مسئلهای انتخاب کردیم که شرطهای روشن و قابلآزمایش داشته باشد؛ این درخواست را به مدل دادیم:
یک تابع پایتون به نام final_total بنویس که دو ورودی میگیرد: قیمتها (فهرستی از عددهای صحیح به ریال) و درصد تخفیف (عدد صحیح بین 0 تا 100). تخفیف فقط روی گرانترین کالای فهرست اعمال میشود و بقیه کالاها قیمت کامل دارند. تابع باید مجموع نهایی را به صورت عدد صحیح برگرداند. اگر فهرست خالی باشد 0 برگردان. برای گرد کردن، قاعده «نیم به بالا» را رعایت کن (مثلاً 2.5 باید 3 شود). همراه تابع، چند تست pytest هم بنویس که حالتهای خاص را پوشش بدهد. فقط کد پایتون بده.
سه چیز این درخواست را قابلآزمایش کرده است: قاعده تخفیف صریح است، رفتار حالت خالی مشخص شده، و قاعده گرد کردن با یک مثال عددی آمده است. بدون این جزئیات، هر خروجیای «درست» به نظر میرسد.
گام 2: کدی که مدل نوشت
این پاسخ مدل بود (اجرا شده در تاریخ 1405/06/29 با مدل Qwen 3 Coder در تاپگیفت AI):
def final_total(prices, discount_percent):
    if not prices:
        return 0
    max_price = max(prices)
    discounted_max = max_price * (100 - discount_percent) / 100
    total = sum(prices) - max_price + discounted_max
    return int(total + 0.5)  # Round half up

def test_final_total():
    assert final_total([], 50) == 0
    assert final_total([1000], 50) == 500
    assert final_total([1000, 2000, 3000], 50) == 5500
    assert final_total([999, 1000], 10) == 1899
    assert final_total([1000, 1000], 50) == 1500
در نگاه اول همهچیز منطقی است: حالت خالی رسیدگی شده، تخفیف فقط روی گرانترین کالا اعمال شده و برای گرد کردن از int(total + 0.5) استفاده شده که قاعده «نیم به بالا» را برای عددهای مثبت رعایت میکند.
گام 3: کد را اجرا کنید، فقط نخوانید
کد را در یک محیط جدا اجرا کردیم. نتیجه این بود:
تستهای خودِ مدل: رد شد. مقدار واقعی برای final_total([1000, 2000, 3000], 50) برابر 4500 بود، در حالی که تست انتظار 5500 داشت.
حساب دستی نشان میدهد حق با تابع است: دو کالای اول کامل حساب میشوند (1000 و 2000) و گرانترین کالا با 50 درصد تخفیف 1500 میشود؛ مجموع 4500 است. یعنی تابع درست بود و تست غلط.
این دقیقاً همان چیزی است که با «خواندن» کد پیدا نمیشود. کد و تست هر دو قانعکننده به نظر میرسیدند؛ فقط اجرا نشان داد یکی از آن دو با دیگری نمیخواند.
گام 4: نتیجه شکست را به مدل برگردانید
بهجای اینکه خودمان عدد را عوض کنیم، متن خطا و حساب دستی را به همان گفتوگو برگرداندیم و پرسیدیم اشکال از تابع است یا از تست. پاسخ مدل:
اشکال در مقدار انتظاری تست بود. محاسبه صحیح برای [1000, 2000, 3000] با 50٪ تخفیف: 1000 + 2000 + 1500 = 4500. بنابراین مقدار انتظاری تست از 5500 به 4500 اصلاح شد. سایر تستها صحیح هستند.
مدل تابع را دستنخورده نگه داشت و فقط عدد تست را اصلاح کرد؛ همان کاری که یک بازبین انسانی هم میکرد.
گام 5: دوباره اجرا کنید
بعد از اصلاح، هم تستهای مدل و هم تستهایی که خودمان نوشته بودیم قبول شدند. تا اینجا زنجیره کامل شد: درخواست روشن، کد، اجرا، شکست، اصلاح، اجرای دوباره.
تستهای خودتان را هم بنویسید
تستهای مدل معمولاً همان حالتهایی را میآزمایند که خودش به آنها فکر کرده است. ما جدا از مدل، این موارد را هم بررسی کردیم:
همان مثال صورتمسئله: تخفیف 50 درصد روی کالای 5 ریالی باید 3 شود (2.5 به بالا)، که شد.
حالتهای مرزی: فهرست خالی، تخفیف 0 و تخفیف 100 درصد.
مقایسه با یک مرجع مستقل: 20000 ورودی تصادفی ساختیم و خروجی تابع را با محاسبه دقیق اعشاری (کتابخانه decimal با گرد کردن نیمبهبالا) مقایسه کردیم. هیچ اختلافی دیده نشد.
این سومی مهمترینشان است: وقتی یک مرجع مستقل دارید، لازم نیست حدس بزنید کد درست است؛ میتوانید نشانش بدهید.
چند الگوی درخواست که در برنامهنویسی جواب میدهد
ورودی و خروجی را نمونهوار بگویید: «برای ورودی [1000, 2000] و تخفیف 10 باید 2800 برگردد» بهتر از توضیح طولانی است.
پیام خطا را کامل بدهید: متن خطا و چند خط کد اطراف آن، نه فقط «کار نمیکند».
یک کار در هر پیام: اول کد، بعد تست، بعد بهینهسازی. سهتایی در یک پیام معمولاً به سه نتیجه نصفه میرسد.
محدودیتها را صریح بگویید: نسخه زبان، کتابخانههای مجاز، و اینکه کد باید بدون وابستگی خارجی اجرا شود.
درباره ساختار کلی یک درخواست خوب، راهنمای سؤالپرسیدن از هوش مصنوعی را ببینید.
کدام مدل برای کد مناسبتر است؟
سازندهها بعضی مدلها را صریحاً برای کدنویسی معرفی میکنند و همانها معمولاً انتخاب بهتریاند. در تاپگیفت AI هم مدلها دستهبندی دارند و دسته «کدنویسی» جداست؛ فهرست کامل و پلن هر مدل در جدول پلنها و مدلهای تاپگیفت AI آمده است. آزمایش این مقاله با Qwen 3 Coder انجام شد که برای حسابهای بدون اشتراک هم فعال است.
اگر میخواهید تفاوت خانوادههای مختلف مدل را بدانید، مقایسه GPT، Claude، Gemini و DeepSeek همین موضوع را با یک آزمایش عملی بررسی کرده است.
چه چیزهایی را در گفتوگو نگذارید
کلید API، توکن دسترسی، رمز پایگاه داده و هر اعتبارنامه دیگر
کد یا داده محرمانه کارفرما و مشتری، بهخصوص اطلاعات شخصی کاربران
فایل تنظیمات محیط (مثل .env) که معمولاً همه موارد بالا را یکجا دارد
اگر برای گرفتن کمک لازم است بخشی از کد را نشان دهید، مقدارهای حساس را با نمونه جایگزین کنید. این کار کیفیت پاسخ را کم نمیکند.
جمعبندی
هوش مصنوعی در برنامهنویسی یک همکار سریع است، نه یک مرجع. روش کار مطمئن، همین چرخهای است که در این مقاله اجرا کردیم: مسئله را با شرطهای روشن تعریف کنید، کد و تست بگیرید، اجرا کنید، نتیجه واقعی را به مدل برگردانید و دوباره اجرا کنید. در همین تمرین کوچک، اجراکردن چیزی را نشان داد که خواندن نشان نمیداد.
برای شروع، یک تابع کوچک از کار واقعی خودتان را انتخاب کنید و همین پنج گام را روی آن ببرید. اگر هنوز حساب ندارید، میتوانید با اعتبار هدیه تاپگیفت AI شروع کنید؛ شرایط آن در همان صفحه آمده است.